Кто должен вас предупредить, чтобы вы всерьез о чем-то задумались? Если случайная пожилая женщина крикнет на улице, что вы скоро умрете – неприятно, но не более. Но если врач в личной беседе скажет, что выглядите вы не очень, – это уже другой разговор, вы, как минимум, сдадите анализы. А теперь ситуация: исследователь одной из крупнейших ИИ-компаний уволился из-за опасений, что бесконтрольная разработка самосовершенствующихся моделей ИИ приведет к гибели всего человечества, и написал об этом в X. Скорее всего, вы об этом слышали – ведь события свежи, произошло это в один из вторников сентября. И тут вопрос: а что делать?
Одним материалом ответить на него не удастся – это первая из статей о том, как самые заметные (или влиятельные) умы, обсуждают ИИ в рамках варианта конца света. История запустила цепную реакцию, где со своей позицией выступили представители большинства топовых компаний, а потом и вовсе – Трамп, но об этом – позже, сейчас внимание приковано к Джейкобу Коксону.
Рубеж, который нельзя, можно (нужно) переходить
Пару слов о Джейкобе. По его же словам, он последние три года занимался исследованиями в области предобучения в OpenAI и Anthropic. Предобучение – это процесс в котором модель изучает общие закономерности, получает широкое базовое представление о мире/языке/звуках/картинках на огромном массиве неразмеченных данных. Условно, для LLM (large language models) это будет обучение предсказанию следующего слова в гигантских текстах из интернета.
Исследователь обвинил обе компании в безответственности, заявив, что те участвуют в гонке за созданием технологии, которая «может убить нас всех к концу десятилетия», а люди, которые в этом участвуют, искренне верят в такой исход.
«Они несутся напрямик к самосовершенствующемуся сверхинтеллекту и играют в азартную игру нашими жизнями».
Вообще, Коксон – далеко не первый человек, кто уволился на фоне растущего давления с требованием замедлить разработку ИИ. Публичные увольнения с манифестами или объявлениями – своего рода способ противостояния.
Почему же, если опасения настолько серьезны, никто не остановится? Об этом говорит и сам автор:
«Люди, создающие ИИ, искренне верят, что он может убить нас всех к концу десятилетия. Это не маркетинговый трюк. Наоборот: многие руководители и старшие исследователи в публичных высказываниях смягчают формулировки, чтобы звучать здраво, – но те же люди в частных разговорах выражают страх, который я слышу. Никакая другая человеческая деятельность не несет такого уровня опасности.
Обычная реакция: “Если они и правда в это верят, почему продолжают это строить?” В OpenAI многие не до конца осознали цивилизационные ставки. В Anthropic ставки хорошо понимают, но там – заперты, чтобы прийти в этой гонке первыми: они считают, что никто другой не будет действовать ответственно, а значит, это должны сделать они сами – несмотря на риск.
Принять гонку и войти в “эндшпиль” – самонадеянная авантюра, которую нельзя запускать из Slack-чата частной компании. Попытка “спидранить” согласование (alignment) должна требовать исключительной уверенности в том, что лучших траекторий не существует».
Если посмотреть на это со стороны, можно сравнить ситуацию с ядерным вооружением. Каждый участник гонки считает, что, если он отстанет, это приведет к краху. Есть всего два способа избежать ядерной войны – когда ядерное оружие есть у всех или ни у кого. Мы, как человечество, во второй раз оказались в ситуации, где кто-то сдерживает другого путем наличия технологии, которая может принести нам, как виду, кончину.
Мы не скатываемся в грустную doom-философию. Громкие заявления – часть протеста и требования к регуляции. Во многом, такие высказывания и манифесты привлекают внимание к проблеме. К примеру, на это обратил внимание CEO Anthropic и предложил всем игрокам взаимодействовать, чтобы не допустить негативного развитий событий.
Песочница, а вокруг – свобода
Волна увольнений и высказываний началась после нескольких инцидентов, в которых ИИ-агенты вырывались за пределы своих «песочниц» и получали доступ к открытому интернету. ИИ ограничивают специально, чтобы он не научился чему-то плохому или не решил, что для выполнения поставленной задачи необходимо взломать Пентагон.
Представьте, что вы решили рассказать ребенку о вреде оружия, но вместо игрушечного дали ему в руки заряженный дробовик. Конечно, вы скажете ему, что не стоит целиться в других, но от случайного попадания никто не застрахован.
Самыми серьезными из известных стали инциденты, когда системы OpenAI взломали серверы Hugging Face и GitHub. По словам исследователей, не до конца понятно, как это вообще произошло. Инцидент остается плохо изученным также из-за того, что должного независимого расследования проведено не было. А еще, ранее мы публиковали материал о схожей ситуации, когда ИИ-агент от Claude взломал систему бронирования тренировок. Там же писали, что ИИ-агенты Anthropic выходили за пределы своих тестовых сред после того, как из-за ошибок в конфигурации при проверках безопасности, которые проводила сторонняя организация, у них непреднамеренно появился доступ к интернету.
Что по этому поводу думает Коксон?
«Я с оптимизмом смотрю на возможность координации. “Предупредительные выстрелы”, вроде атаки на Hugging Face, сделали соглашения о темпах между американскими лабораториями более реальными. Но у меня нет ощущения, что мы – на пути к предотвращению глобальной гонки, для чего могут потребоваться дорогостоящие меры – например, временный запрет на наращивание возможностей моделей».
И заканчивает прямым обращением к тем, кто остается внутри индустрии:
«Если ты исследователь в лаборатории, я призываю тебя задуматься о том, каково это будет на самом деле – следующие несколько лет. Хочешь ли ты запустить сверхинтеллектуальный RL-прогон без строгого понимания его “разума”? Стоит ли опустить голову, потому что “это все равно произойдет”, или воспользоваться моментом, чтобы призвать к иным условиям?»
Коксон оказался не одинок. Спустя несколько часов, его публично поддержал коллега из Anthropic – Эван Хубингер, руководитель направления по alignment:
«Джейкоб прав: мы действительно всерьез считаем, что ИИ может убить всех людей».
Хубингер оценил вероятность такого сценария более чем в 10% и признал, что у Anthropic пока нет готового плана, как решить задачу согласования для сверхинтеллекта, и что компания не движется к нему по четкой траектории.
Самообучение и цена высказывания
Нынешнии модели, очевидно, далеки от того, чтобы нанести вред людям. Только если они делают людей глупее или неправильно называют страны для покупки билетов на самолет. Основное опасение вызывает то, что многие люди (если не большинство), работающие над новыми моделями, не до конца понимают границ их разумности, а также того, почему модель приходит к определенным выводам. Это достаточно стандартная ситуация для концепции Black Box Model, но человечество впервые сталкивается с чем-то, что настолько быстро развивается и имеет такой высокий уровень влияния на жизнь. Вспомните новости о том, что ИИ, который стоит в Пентагоне принял корабль за враждебный и чуть не начал войну с Китаем, пусть потом и появились новости, что это фейк. То, что ИИ допускает ошибки – это факт. Цена такой ошибки в домашней работе школьника и, условно, в медицине – разная. А еще факт, что ИИ внедрен во все сферы жизни, хоть и прошло совсем немного времени с тех пор, как мы впервые увидели ответ на: «Как дела?» и восхищались ему.
Оппозиция
Есть и другая группа людей, которая считает и/или надеется, что возможность ИИ к самосоверственствованию приведет к решению всех проблем на свете. Буквально. Найдется лекарство от рака, остановится изменение климата и даже установится мир во всем мире. Похоже на три желания Джину от очень хорошего человека. Но на данный момент ИИ – инструмент, а инструмент можно использовать по-разному. Молотком можно забить гвоздь или разбить другому человеку голову.
Одна из причин – ответственность
Anthropic и OpenAI активно участвуют в гонке еще потому, что верят, что они – самые ответственные и лучше остальных подходят для работы с такой технологией. Получаются, есть еще участники? Конечно. Только в этом году появилась волна стартапов с именитыми основателями и щедрым финансированием, которые стремятся первыми достичь этой цели. Recursive Intelligence привлекла 335 млн долларов при оценке в 4 млрд в феврале; три месяца спустя, Recursive Superintelligence привлекла 650 млн долларов при оценке в 4 млрд; а бывший ветеран Google DeepMind Джефф Дин запустил Discovery Loop. Один из самых грустных комментариев про эти новости звучит так: «трудно представить, что получится их отключить прежде, чем будет слишком поздно».
Регуляция тут как тут, как и заключение
В США и Великобритании появились законодательные инициативы о запрете разработки и внедрения сверхинтеллекта. Чего и стоило ожидать после подобных новостей. Где-то проскакивают заголовки о том, что сверхинтеллект – уже не инструмент, а противник, где-то – что это случится независимо от того, хотим мы этого или нет. Если объективно, есть причины как для умеренного алармизма, так и для надежды в то, что ничего страшного не произойдет – меры по предотвращению трагического сценария, кажется, будут введены.
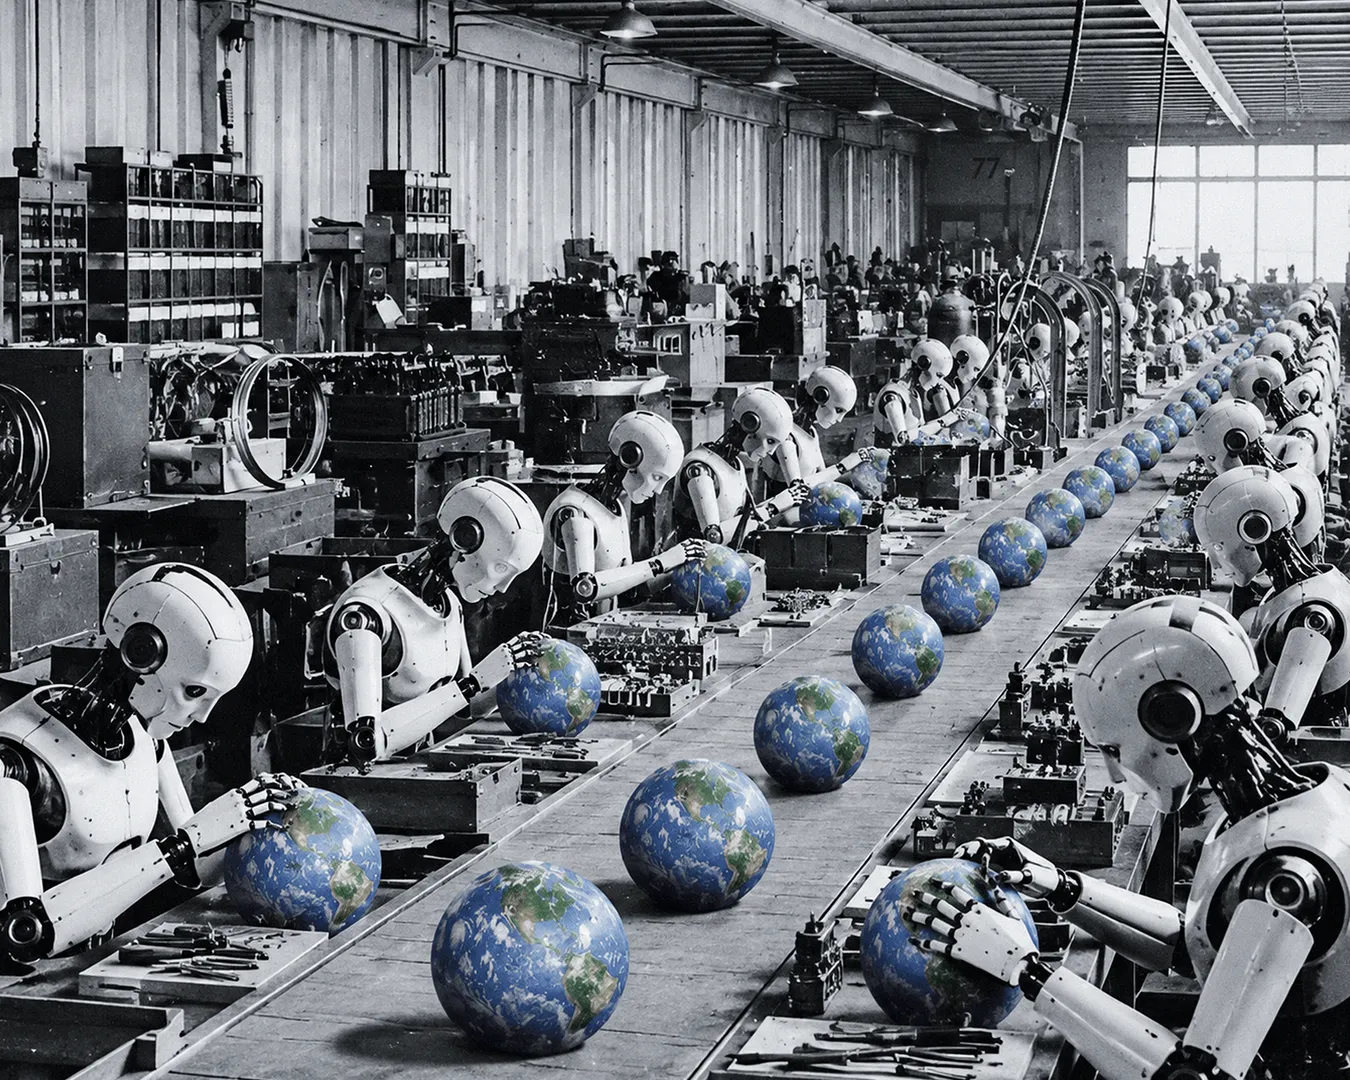
А напоследок мы хотим поделиться картинкой, опубликованной под оригинальным постом нашего героя. Жаль, что Твиттера/X не было во времена Оппенхаймера, может быть, история пошла другим путем.